Как подготовить CSV-выгрузку к анализу с ИИ
Проверим кодировку, разделители, типы данных, пропуски и дубли. На учебной выгрузке пройдём очистку и сверку, сохранив исходные значения.

Практикум Романа Ботана · Автомато
Начните с небольшой копии выгрузки заказов или клиентов. Составим словарь столбцов, найдём неоднозначные значения и подготовим проверенный файл для анализа.
Результат работы: Чистая выгрузка и журнал изменений.
Материал рассчитан на последовательную работу. Откройте исходники рядом со статьёй, выполняйте запросы по одному и сверяйте промежуточный результат. Содержание поможет вернуться к нужному этапу.
Где CSV помогает в ежедневной работе
У вас есть выгрузка клиентов из CRM. В одних строках город записан полностью, в других сокращённо. Несколько клиентов повторяются. Часть контактов отсутствует, а менеджеры используют разные названия одного статуса. ИИ может помочь найти такие расхождения и подготовить аккуратный результат, если задача и структура данных понятны заранее.
CSV — текстовый формат табличных данных. Он подходит для списков товаров, заявок, компаний, отзывов и других записей, которые естественно раскладываются по строкам и столбцам. В нём удобно передавать значения между программами и получать результат массовой обработки. Для предпринимателя главное преимущество связано с простотой проверки: можно сопоставить исходную запись и итоговую, посчитать строки, проверить ключи и увидеть изменения.
Что мы сделаем в этом руководстве
Разберём устройство CSV, подготовку к загрузке в ИИ, очистку, классификацию и приёмку результата. Отдельно пройдём два учебных бизнес-примера: наведение порядка в клиентской базе и распределение товаров по категориям. В конце подготовим небольшой файл к импорту и разберём упражнение с ответом.
Формат не исправляет смысловые ошибки автоматически. Если в столбце «Выручка» смешаны рубли и тысячи рублей, аккуратные разделители не помогут получить правильную сумму. Если одинаковое название компании относится к двум разным юридическим лицам, простое удаление дублей может уничтожить полезную запись. Поэтому начнём с правил данных, затем перейдём к обработке.
Работайте с копией выгрузки и сохраняйте исходный файл. Для первого запуска выберите небольшой обезличенный набор, который можно проверить вручную. Возможность ИИ читать и создавать файлы зависит от конкретного продукта и доступных инструментов. Перед массовой обработкой убедитесь, что в вашей среде действительно открывается CSV и сохраняется результат, доступный для скачивания.
Цель обучения — научиться получать проверяемый файл, который пригоден для следующего действия. Это может быть анализ, загрузка в CRM или передача сотруднику. Каждый вариант требует своих критериев, и мы будем задавать их явно.
Как устроен CSV и почему важна запись
В простом CSV первая строка содержит названия столбцов, а следующие — значения. Разделителем обычно служит запятая. Некоторые программы используют точку с запятой или другой согласованный символ; такой вариант требует правильной настройки чтения. Расширение .csv само по себе не сообщает все детали.
Учебный пример:
client_id,company,city,orders
C001,Компания Альфа,Казань,3
C002,Компания Бета,Самара,1
C003,Компания Гамма,Казань,0
Здесь одна запись описывает одного клиента. client_id связывает строку с исходной системой, company хранит название, city — город, orders — количество заказов за оговорённый период. Без периода последний столбец остаётся неоднозначным. Три заказа за месяц и три заказа за пять лет дают разный смысл для анализа.
Логическая запись и физическая строка
Для обучения удобно говорить «одна строка — один объект». При этом CSV допускает перенос строки внутри значения, заключённого в кавычки. Тогда одна логическая запись занимает несколько физических строк текстового файла. Поэтому считать записи простым подсчётом переносов ненадёжно. Нужен инструмент, который понимает CSV и корректно читает кавычки.
Все записи должны соответствовать одной схеме. Если в середине файла появляется заголовок «Продажи за февраль» или другая таблица, обработка становится неоднозначной. Лучше добавить столбец периода либо разделить разные сущности на отдельные файлы. Так программа понимает, что каждая запись имеет одинаковый набор полей.
CSV не хранит полноценную модель типов. Значение 00125 может означать код, а программа ошибочно распознает его как число. Значение 01-02 может быть артикулом или датой. Тип и смысл следует задавать в описании данных и при импорте. Важные идентификаторы обычно обрабатывают как текст.
Перед работой сформулируйте одно предложение: «Каждая запись в этом файле — …». Если предложение получается длинным и содержит несколько разных объектов, структуру стоит уточнить до загрузки в ИИ.
CSV, XLSX и JSON: выбираем по задаче
CSV удобен, когда нужны значения одной плоской таблицы. Например, список клиентов для сегментации или каталог товаров для классификации. XLSX сохраняет возможности электронной книги: несколько листов, формулы, оформление и другие элементы. JSON подходит для структур, где внутри объекта есть вложенные списки и дополнительные уровни.
Начните с вопроса о том, что необходимо сохранить. Если задача заключается в проверке формул бюджета, нужен исходный рабочий файл с формулами. Если требуется распределить отзывы по темам, достаточно текста отзыва, идентификатора и полезных атрибутов. Если у каждой компании есть несколько офисов с собственными контактами, возможно, удобнее несколько связанных таблиц или вложенная структура.
Что теряется при упрощении книги
В CSV обычно переходят значения выбранной таблицы. Формат не переносит всю структуру книги, оформление и поведение формул. Поэтому перед экспортом сохраните исходный XLSX и проверьте, какие данные фактически попали в файл. Цвет ячейки иногда кодирует важный смысл: красным отмечена просрочка, жёлтым — ожидание проверки. Этот смысл надо превратить в отдельный столбец, если он нужен для анализа.
Допустим, на одном листе показана выручка, на другом расходы, а третий рассчитывает прибыль. Экспорт одного листа может быть достаточен для анализа готовых значений за период. Для проверки логики расчёта нужен весь контекст книги. Решение зависит от вопроса, который вы задаёте ИИ.
Другой пример: контент-план содержит тему, дату, канал и статус. Если оформление помогает только человеку, CSV подойдёт для переноса записей между сервисами. Если к каждой публикации приложены несколько файлов, комментарии и история согласования, один CSV может покрывать лишь часть процесса.
Оцени, подходит ли CSV для моей задачи: [задача]. Опиши, какие данные и связи нужно сохранить. Проверь, есть ли в исходном файле формулы, несколько связанных листов, смысловое оформление или вложенные сущности. Предложи формат результата и объясни возможные потери при преобразовании. До согласования работай с копией и сохраняй исходник.
Такой короткий предварительный анализ часто предотвращает трудную ситуацию, когда удобная выгрузка уже потеряла информацию, необходимую для правильного ответа.
Описываем схему данных до обработки
Схема — договорённость о столбцах и их значении. Для небольшой задачи достаточно короткого описания каждого поля: название, смысл, допустимый тип, единицы и поведение при пропуске. Сложная техническая документация здесь обычно не нужна. Главное, чтобы человек и ИИ одинаково понимали данные.
Например: «amount — сумма оплаченного заказа в рублях, после скидки, без стоимости доставки». Такая формулировка сразу снимает несколько вопросов. Просто «сумма» оставляет место для разных трактовок. Для даты уточните событие: создание заявки, оплата или отгрузка. Для статуса перечислите допустимые значения.
Определяем неизменяемые поля
Выделите столбцы, которые нельзя менять: идентификатор, исходный текст, номер заказа, дата выгрузки. Если требуется нормализация названия, полезно сохранить исходное значение и добавить отдельный результат. Например, city_original и city_normalized. Тогда исправление можно проверить и при необходимости отменить.
Укажите, можно ли менять порядок записей. Для некоторых импортов это несущественно, однако при ручной проверке сохранённый порядок облегчает сравнение. Надёжнее сопоставлять записи по уникальному ключу, поскольку сортировка не должна нарушать связь. Если ключа нет, создайте технический идентификатор исходной записи до обработки.
Пропуски требуют отдельного решения. Пустая ячейка может означать неизвестное значение, отсутствие применимости или незавершённый ввод. Ноль имеет конкретный числовой смысл. Подмена пустой суммы нулём способна изменить среднее значение и выводы. Попросите ИИ перечислить такие неоднозначности до расчётов.
Сначала составь паспорт этого CSV: что означает одна запись, сколько записей и столбцов прочитано, какие типы обнаружены, где есть пропуски и повторяющиеся ключи. Используй описание полей: [описание]. Идентификаторы и исходные значения сохраняй. Если смысл столбца неоднозначен, задай вопрос. Пока выполняй только анализ, без удаления и исправления записей.
После ответа сверьте несколько строк с исходной системой. Проверка схемы на реальных примерах помогает обнаружить неверное чтение ещё до того, как ошибка распространится на весь массив.
Разделители, кавычки, кодировка и числа
CSV кажется простым, пока внутри текста не появляется запятая. Если она используется как разделитель, такое значение заключают в двойные кавычки. Например, описание Монтаж, настройка и обучение должно оставаться одним полем. Иначе программа увидит дополнительные столбцы и сдвинет остальные значения.
service_id,description,price
S001,"Монтаж, настройка и обучение",15000
S002,"Проверка оборудования ""Стандарт""",5000
Во втором примере кавычки внутри значения удвоены. Это распространённое правило CSV. Поля с переносом строки также требуют корректного заключения в кавычки. Общие правила записи описаны в RFC 4180. При практической работе учитывайте требования принимающей программы, поскольку реальные реализации различаются.
Кодировка и локальные настройки
Для русского текста часто выбирают UTF-8. Если после открытия видны нечитаемые символы, сначала проверьте способ импорта и кодировку. Повторное сохранение уже повреждённого текста может закрепить ошибку. Работайте с исходной копией и меняйте параметры чтения, пока символы не станут корректными.
Числа тоже зависят от договорённостей. В одних системах десятичная часть отделяется точкой, в других запятой. Если запятая одновременно разделяет поля, значения нужно корректно заключать в кавычки либо использовать согласованный другой разделитель. Для импорта задавайте конкретный формат, который ожидает целевая система.
Даты лучше хранить в однозначном формате, например год-месяц-день. Но сначала убедитесь, что исходная дата понятна. Запись 03/04/2026 может интерпретироваться по-разному. ИИ не должен молча выбирать вариант. При наличии времени укажите часовой пояс, если он влияет на отчёт или дедлайн.
Коды, телефоны и почтовые индексы часто следует сохранять как текст. Иначе потеряются ведущие нули или изменится представление длинного числа. После открытия в табличном редакторе проверьте такие столбцы отдельно. Удобный внешний вид таблицы ещё не подтверждает сохранность точных значений.
Первый безопасный запуск: проба на небольшом наборе
Перед обработкой всей базы выберите небольшой набор, включающий разные случаи. Возьмите обычную запись, пропуск, дубль, длинный текст с запятой, необычный идентификатор и неоднозначное значение. Случайные первые десять строк могут оказаться слишком простыми и скрыть проблему.
Попросите ИИ сначала прочитать файл и показать параметры: разделитель, кодировку, названия столбцов и количество логических записей. Затем дайте одну конкретную операцию. Например, привести названия городов к согласованному справочнику, сохранив исходные поля. Только после проверки добавляйте следующую задачу.
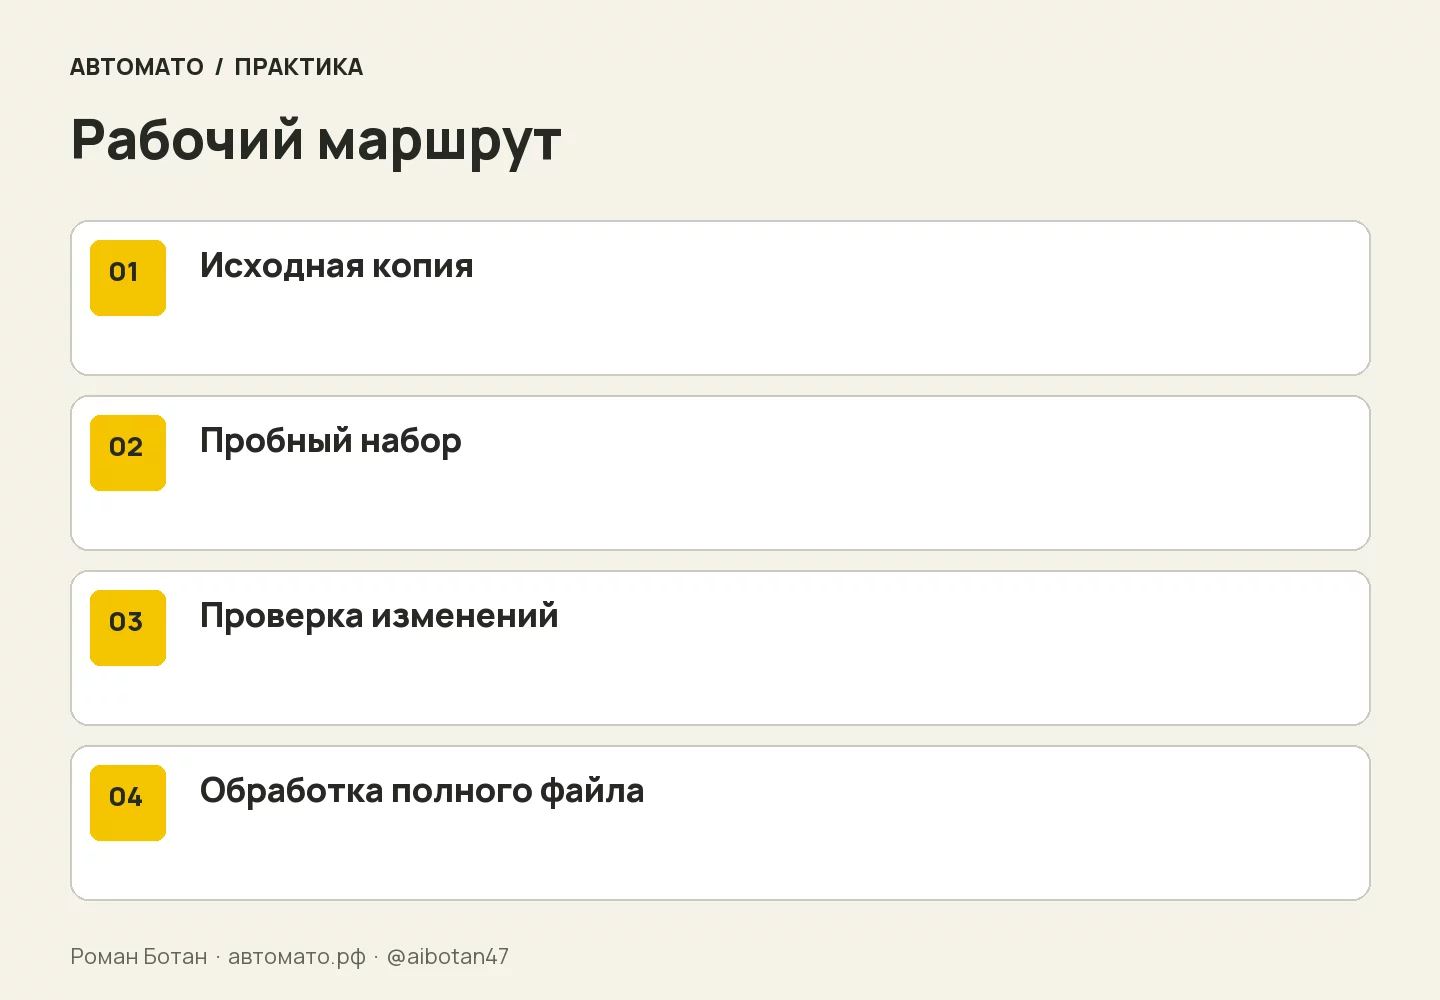
Последовательность действий: Исходная копия → Пробный набор → Проверка изменений → Обработка полного файла.
Что принимать после пробы
Проверьте, сохранились ли ключи, количество записей и связь между полями. Если порядок менять запрещено, он должен совпадать. Если добавлен новый столбец, его значения должны соответствовать правилам. Посмотрите все необычные случаи вручную. Небольшая проба ценна именно возможностью проверить её целиком.
На пробном файле нормализуй только поле city по справочнику: [справочник]. Сохрани все исходные столбцы, строки и их порядок. Добавь city_normalized и review_reason. Неопределённые значения оставь без нормализованного города и объясни причину. Верни отдельный CSV и отчёт: входных записей, выходных записей, изменённых значений, записей для проверки. Покажи результат для всех учебных случаев.
Если модель угадывает город по названию компании или заполняет отсутствующие данные, уточните правила и повторите пробу. Массовый запуск с неясным поведением только увеличит объём последующей проверки. Ошибка на шести строках удобна для обучения; та же ошибка на десятках тысяч строк становится отдельной операционной задачей.
После успешного теста сохраните формулировку задания и параметры формата. Для похожей следующей выгрузки они послужат отправной точкой. При этом перед повторным запуском всё равно проверяйте схему: CRM или поставщик данных могли добавить столбец либо изменить способ записи даты.
Очистка: дубли, стандартизация и пропуски
Очистка включает разные операции, и их лучше задавать отдельно. Полный дубль — запись, совпадающая по согласованным полям. Похожая запись — возможное совпадение, которое требует правила объединения или проверки. Две компании с одинаковым названием могут иметь разные идентификаторы и быть разными клиентами.
Начните с полного дублирования. Определите, какие поля участвуют в сравнении и какую запись сохранять. Если отличаются даты обновления, задача уже сложнее: потребуется выбрать актуальные значения и сохранить историю или связь. Для первого запуска безопаснее подготовить список кандидатов, который проверит ответственный сотрудник.
Нормализация значений
Приведение стран, городов и статусов к справочнику уменьшает разнобой. Например, «СПб» и «Санкт-Петербург» могут получить одно согласованное значение. Однако похожие сокращения в другом наборе данных могут означать другое. Словарь преобразования делает правило явным и повторяемым.
Пробелы в начале и конце поля часто можно убрать автоматически. Внутренние пробелы иногда значимы: название, код или номер документа могут зависеть от точной записи. Поэтому даже простую очистку задавайте по столбцам. Общее указание «исправь очевидные ошибки» оставляет слишком широкую свободу.
Пропущенные сведения не следует заполнять правдоподобными догадками. Если нужен внешний поиск, это отдельный этап с указанием источника и даты проверки. Если данные неизвестны, сохраните пропуск и отметку. Для анализа иногда допустимо исключить такие записи из конкретного расчёта, но это решение нужно показать в отчёте.
Найди полные дубли по полям [поля] и кандидатов на совпадение по [критерии]. Полные дубли вынеси в отдельный список с ключом сохраняемой записи. Похожие записи пока не объединяй. Нормализуй только согласованные значения по приложенному словарю. Добавь отчёт о каждом типе изменения и перечень неоднозначных случаев. Исходный файл сохрани отдельно.
После очистки полезно проверить контрольные суммы и количество уникальных ключей. Если задача не должна менять денежные значения, их сумма до и после должна совпасть с учётом явно согласованного удаления дублей. Любое расхождение требует объяснения до дальнейшего использования результата.
Классификация и обогащение: где заканчиваются данные
Классификация добавляет к записи категорию на основании имеющейся информации. Например, отзыв получает тему, товар — раздел каталога, заявка — тип обращения. Обогащение добавляет сведения из других источников. Эти процессы требуют разных доказательств, поэтому задавайте их отдельно.
Для классификации подготовьте перечень категорий и определения. «Высокий приоритет» без критериев превращается в субъективную оценку. Более ясное правило: «Высокий приоритет присваивается заявке с указанным сроком до трёх рабочих дней и заполненным контактом». Если данных недостаточно, допустима категория «Требует проверки».
Проверяем границы категорий
Дайте агенту несколько положительных и пограничных примеров. Покажите товар, который точно относится к категории, и похожий товар, который относится к другой. Это помогает обнаружить пересечение правил. Если одна запись может иметь несколько тем, заранее решите, нужен ли один основной класс или несколько отдельных признаков.
При обогащении компании по сайту сохраняйте адрес источника, дату проверки и краткое основание. Название компании само по себе не подтверждает отрасль, размер или выручку. Если сайт недоступен или источник неоднозначен, результат должен показывать ограничение. Придуманные данные опасны именно тем, что выглядят аккуратно в таблице.
Классифицируй записи по приложенному справочнику категорий. Используй только поля title и description. Исходные столбцы сохраняй. Добавь category, reason и needs_review. Если информации недостаточно или подходят несколько категорий, отметь проверку и объясни причину. Сначала обработай двадцать разнообразных записей. После моей проверки применим согласованные правила ко всему файлу.
Проверяйте не только случайную выборку, но и каждую редкую категорию, короткие описания, пустые поля и пограничные случаи. Общая доля правильных ответов может скрывать систематическую ошибку в небольшой, но важной группе. Например, все товары с определённым сокращением могут попадать в неверный раздел.
После согласования правил сохраните их рядом с результатом в кратком описании задания. Это позволит объяснить, почему запись получила конкретную категорию, и повторить обработку при обновлении каталога.
Расчёты и анализ: проверяем единицы и основания
CSV часто используют для расчёта продаж, распределения заявок и анализа отзывов. Перед расчётом определите показатель словами. «Средний чек» может считаться по оплаченным заказам, всем созданным заказам или отдельным позициям. Если единица наблюдения выбрана неправильно, формула даст точное число с неверным смыслом.
Уточните период и условия включения. Например: «Сумма оплаченных заказов за август по дате оплаты, с учётом возвратов отдельным показателем». Затем определите группировку: город, менеджер, канал. Полезно попросить ИИ показать формулу или алгоритм расчёта и количество записей, участвующих в каждом результате.
Контрольный пример
Возьмите три заказа: 1000, 2000 и 3000 рублей. При одинаковых условиях среднее равно 2000. Добавьте отменённый заказ на 9000 и уточните, должен ли он участвовать. Такая маленькая проверка помогает выявить ошибку фильтра до анализа полного месяца.
Пропуски и нули учитывайте отдельно. Пустая сумма может означать ошибку выгрузки. Нулевая сумма может быть допустимым бесплатным заказом. Если ИИ заменит оба случая нулём, среднее изменится. В отчёте должны быть видны исключённые записи и причины исключения.
Рассчитай [показатель] за [период] по следующим правилам: [условия]. Сначала повтори определение показателя и единицу одной записи. Покажи количество включённых и исключённых записей, причины исключения и контрольный расчёт на пяти строках. Верни итоговые агрегаты отдельным CSV, сохрани исходные данные. Выводы отдели от предположений о причинах изменений.
Найденная связь ещё не объясняет причину. Если продажи одного менеджера выше, это может зависеть от состава клиентов, региона или времени работы. Аналитический вывод должен учитывать доступные данные. Для управленческого решения полезно сформулировать, какой дополнительный факт поможет проверить гипотезу.
Проверяйте итоговые суммы с исходной системой за тот же период и по тем же правилам. Совпадение с предыдущим отчётом приятно, но различия иногда объясняются изменением определения. Зафиксированная методика позволяет обсуждать такие расхождения предметно.
Учебный бизнес-пример: клиентская база перед сегментацией
Допустим, сервисная компания выгрузила двести клиентов. В файле есть идентификатор, название, город, количество заказов за год и дата последнего обращения. Руководитель хочет выделить клиентов для последующего анализа потребностей. Задача нашего этапа — подготовить данные и сегменты; отправка сообщений клиентам в неё не входит.
Сначала сохраняем исходник и описываем поля. Количество заказов относится к календарному году, дата обращения записана в формате год-месяц-день, идентификатор является текстом. Затем проверяем ключи и обнаруживаем четыре полных дубля и семь похожих названий с разными ключами. Полные дубли можно обработать по согласованному правилу, похожие отправляем на проверку.
Последовательность действий
На пробном наборе нормализуем города. Затем добавляем сегмент по понятному правилу: ноль заказов, один заказ, два и более. Отдельный признак показывает давность последнего обращения. Это учебная схема; реальная компания должна связать сегменты со своей задачей и доступными данными.
Образец результата: «Входных записей 200. После согласованного удаления четырёх полных дублей осталось 196. Семь возможных совпадений сохранены и помечены. Три города требуют уточнения. Сегмент рассчитан для записей с корректным количеством заказов. Пять пропусков в этом поле вынесены в проверку». Такой отчёт позволяет понять фактический объём работы.
Подготовь клиентскую базу к сегментации. Сохрани client_id текстом. Удали только полные дубли по согласованному набору полей, сохрани журнал соответствий. Нормализуй города по словарю. Добавь сегменты по количеству заказов: 0, 1, 2 и более. Пропуски и некорректные значения пометь для проверки. Верни основной CSV, список исключений и контрольные количества. Никаких действий в CRM пока не выполняй.
Руководитель проверяет сегменты на знакомых клиентах и отдельно просматривает исключения. Затем файл можно использовать для планирования дальнейшей работы. Если потребуется импорт в CRM, он будет самостоятельным шагом с проверкой сопоставления полей и поведения обновления.
Польза такого подхода в том, что результат можно объяснить: каждая запись сохранила ключ, каждый сегмент имеет правило, каждое исключение видно. Это основа для дальнейшего управленческого решения.
Учебный бизнес-пример: категории товаров для каталога
Во втором примере магазин получил от поставщика тысячу товарных позиций. В названиях есть сокращения, описания заполнены неравномерно, а категории поставщика отличаются от структуры магазина. Нужно добавить категорию магазина и подготовить предложения для проверки контент-менеджером.
Начинаем со справочника собственных категорий. Для каждой записываем критерии включения и пограничные случаи. Затем выбираем около двадцати разных товаров: простые, сложные, с коротким описанием и похожими названиями. Артикулы сохраняем как текст, цены и остатки оставляем без изменений.
Как выглядит хороший результат
Агент добавляет category, reason и needs_review. Обоснование короткое: «В описании указан настенный монтаж и назначение для освещения». Если описание не позволяет различить два раздела, запись получает пометку проверки. Агент не дописывает характеристики товара, чтобы сделать классификацию удобнее.
Образец строки в человеческом виде: «Артикул 00127; исходное название сохранено; предложена категория “Комплектующие”; основание — описание указывает на сменную деталь; требуется проверка совместимости». Даже при правильной категории совместимость остаётся отдельным вопросом, если поставщик её не подтвердил.
Добавь категории магазина к товарам поставщика по приложенному справочнику. Используй только исходные название и описание. Артикул, цену, остаток и текст поставщика сохраняй дословно. Добавь category, reason и needs_review. Сначала покажи разнообразную пробу, включая пустые описания и спорные случаи. После согласования обработай весь файл. Верни количество записей по категориям и список всех исключений.
После пробы контент-менеджер уточняет одно правило: аксессуары для определённого оборудования относятся в самостоятельный раздел. Исправляем справочник и повторяем классификацию затронутой группы. Это важнее ручной правки только нескольких видимых строк: правило должно одинаково работать для всей группы и следующей поставки.
Перед импортом сравниваем артикулы, цены и остатки с исходником. Затем проверяем небольшой тестовый импорт в разрешённой среде. После него открываем карточки товаров и убеждаемся, что категория отображается правильно. Файл считается подготовленным к импорту после проверки структуры; успешный импорт подтверждается уже в целевой системе.
Готовим файл к импорту и проверяем результат в системе
Принимающий сервис может ожидать определённые названия полей, кодировку, разделитель и формат дат. Поэтому начните с его действующего шаблона или документации. Если система требует email, столбец «Электронная почта клиента» не обязательно распознается автоматически. Иногда сопоставление выполняется вручную при загрузке.
Особенно важно понять поведение повторного импорта. Сервис может создавать новые записи, обновлять существующие по ключу или пропускать совпадения. Один и тот же файл при разных настройках даёт разные последствия. Перед массовой загрузкой уточните идентификатор обновления и правила пустых значений: пустое поле иногда способно стереть существующую информацию.
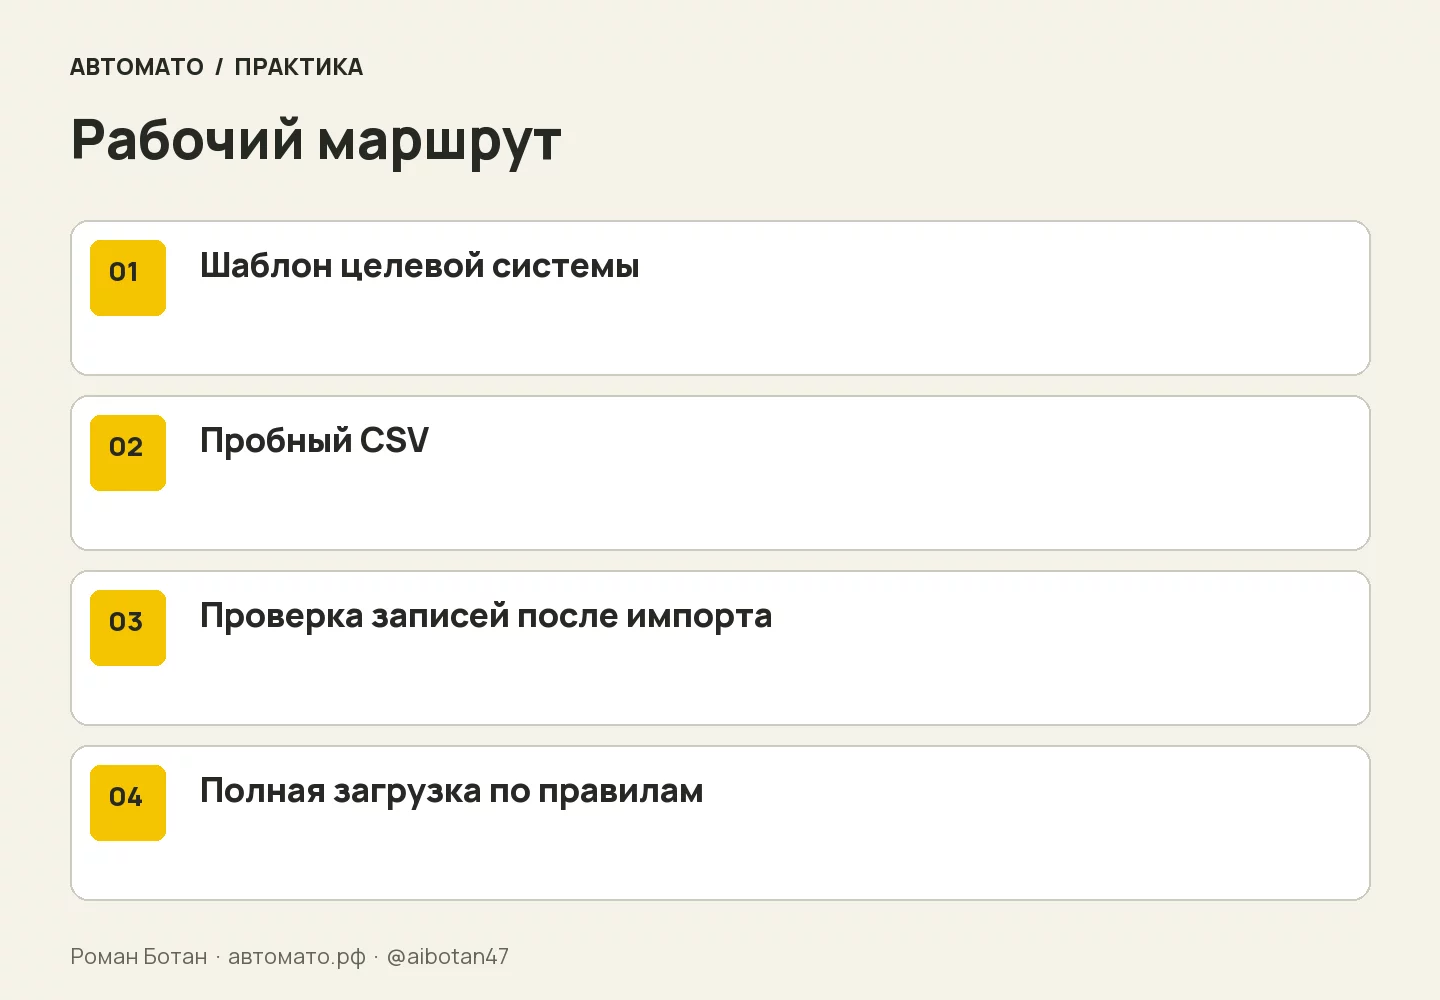
Последовательность действий: Шаблон целевой системы → Пробный CSV → Проверка записей после импорта → Полная загрузка по правилам.
Пробный импорт
Выберите несколько записей, которые можно безопасно проверить. Включите обычный случай, длинный текст, пустое необязательное поле и идентификатор с ведущими нулями. Используйте тестовую среду или явно согласованный небольшой рабочий набор. Сохраните сведения о том, какие записи будут затронуты.
После загрузки откройте сами карточки в системе. Проверьте русские символы, даты, числовые значения и связь полей. Сообщение «импорт завершён» подтверждает выполнение операции, но может скрывать неверное сопоставление. Отдельно посмотрите отчёт об отклонённых строках и предупреждениях.
Подготовь CSV по приложенному шаблону импорта. Сопоставь каждое исходное поле с целевым и покажи преобразования. Ключи обновления сохраняй. Пустые значения обрабатывай по правилам: [правила]. Сначала создай пробный файл из согласованных записей. Проверь чтение CSV и количество полей. Сам импорт выполняй только в рамках отдельно заданного действия и доступной среды.
Если система принимает формулы при открытии текстовых полей в табличном редакторе, отдельно учитывайте значения, начинающиеся со служебных знаков. Особенно это важно для данных из внешних источников. Способ безопасной обработки должен соответствовать целевому инструменту и сохранять смысл исходного значения.
После успешной пробы используйте те же параметры для полного файла. Сравните число созданных, обновлённых и отклонённых записей с ожиданием. Все расхождения разберите до повторной загрузки, чтобы не создать дубли или случайно перезаписать данные.
Приёмка CSV: что проверять кроме первых строк
Проверка первых пяти строк подтверждает только эти строки. Для массовой обработки нужен набор контрольных признаков. Сравните количество логических записей, набор столбцов, уникальность ключей и сохранность полей, которые запрещено менять. Если выполнялась сортировка, сопоставляйте по ключу.
Дальше проверяйте правила. Каждая категория должна входить в справочник. Каждая дата должна читаться в оговорённом формате. Число должно находиться в допустимом диапазоне. Строки с неопределённостью должны иметь отметку, а обоснования — ссылаться на доступные данные. Такие проверки удобно автоматизировать, если инструменты среды это позволяют.
Выборка должна покрывать риск
Смотрите обычные записи, исключения, редкие категории, длинные значения, пропуски и крайние числа. Если классификация влияет на важное действие, долю ручной проверки увеличивают. Для значимых изменений данных может понадобиться проверка каждой изменённой записи. Объём контроля определяется последствиями ошибки.
Полезно повторно открыть сохранённый CSV тем же способом, которым его прочитает следующая программа. Это проверяет реальную запись файла, включая кавычки и кодировку. Таблица внутри памяти инструмента может быть правильной, а экспорт — содержать ошибку формата. Поэтому проверка после сохранения имеет самостоятельный смысл.
Проверь готовый CSV повторным чтением. Сравни с исходником по ключу: количество записей, набор ключей и неизменяемые поля. Проверь допустимые категории, форматы дат, пропуски и числовые диапазоны. Составь отчёт о расхождениях и покажи примеры каждого типа. Отдельно укажи, что проверено автоматически, что просмотрено вручную и что ещё требует проверки в целевой системе.
Хорошая сдача результата содержит файл, краткие правила обработки и отчёт о проверках. Для простого задания достаточно нескольких абзацев; большой пакет документации обычно избыточен. Главное — возможность понять, что изменилось, почему изменилось и как проверить результат.
Если контроль выявил проблему, исправляйте причину в правиле обработки. Ручное исправление пары строк может скрыть систематическую ошибку и оставить её в остальных записях. После изменения повторите затронутые проверки и убедитесь, что остальные ограничения сохранились.
Упражнение с ответом и первый рабочий результат
Есть учебный CSV из четырёх записей. Две полностью совпадают. В одном городе используется сокращение, в другом значение отсутствует. Артикул клиента содержит ведущие нули. Задача — нормализовать город по словарю, удалить только полный дубль и сохранить точные ключи.
client_id,company,city
001,Компания Альфа,СПб
002,Компания Бета,Казань
002,Компания Бета,Казань
003,Компания Гамма,
Словарь содержит одну замену: «СПб» → «Санкт-Петербург». Создайте новый столбец city_normalized и отметку needs_review. Исходный город сохраните. Перед обработкой запишите ожидаемые контрольные количества: четыре входные записи, три выходные, один удалённый полный дубль, одна запись с пропуском города.
Образец ответа
client_id,company,city,city_normalized,needs_review
001,Компания Альфа,СПб,Санкт-Петербург,false
002,Компания Бета,Казань,Казань,false
003,Компания Гамма,,,true
Сопроводительный отчёт объясняет: ключи сохранены как текст; удалено одно полное повторение записи 002; город клиента 001 нормализован по словарю; для клиента 003 сохранён пропуск и добавлена проверка. При чтении в табличном редакторе столбцу client_id нужно назначить текстовый тип, чтобы ведущие нули сохранились.
Если ИИ написал для третьей компании случайный город, результат не соответствует задаче. Если ключ 001 превратился в 1, нарушена сохранность идентификатора. Если исчезла запись с пустым городом, нарушено правило удаления. Эти ошибки легко увидеть на учебном наборе и использовать для уточнения следующего запроса.
Для первого рабочего запуска выберите процесс с понятной проверкой: нормализация городов, классификация отзывов или подготовка небольшого каталога. Сохраните исходник, схему, пробу и итоговый файл. Назначьте человека, который принимает спорные случаи. После проверки используйте результат в следующем действии и отдельно подтвердите его корректность там.
Как повторить обработку через месяц
Допустим, через месяц вы получили следующую выгрузку. Сначала сравните её схему с предыдущей: названия столбцов, типы значений, разделитель и смысл периода. Затем повторите небольшую пробу с новыми исключениями. Сохранённый промпт ускоряет старт, однако он не заменяет проверку изменившегося источника.
Если поставщик добавил новую категорию или CRM изменила статус, обновите справочник осознанно. Покажите владельцу процесса, какие записи затронуты. После согласования примените новое правило ко всей соответствующей группе. Для будущего повторения достаточно коротко записать принятое изменение и дату, чтобы команда понимала причину различий между результатами двух месяцев.
Оценивать пользу процесса можно по времени ручной обработки и количеству исправлений после импорта. Сравнивайте похожие по объёму и сложности наборы. Если времени стало меньше, но выросло число незаметных ошибок, следует усилить контроль или сузить автоматическую часть. Хороший рабочий сценарий даёт одновременно понятную экономию усилий и проверяемую сохранность данных.
Источники и границы материала
Проверено 20 сентября 2026 года. Все компании, количества и операции в бизнес-примерах учебные.
Продолжить практику
- Как получить от ИИ рабочий DOCX или XLSX: постановка и приёмка
- Из одного материала в серию публикаций: рабочий процесс с ИИ
Автор — Роман Ботан, Автомато. Практикумы и обучение · Новые разборы в канале @aibotan47.