Jev от TypeSafe AI: как встроить быстрые решения в бизнес-процессы
Как Jev распределяет обращения, оценивает срочность и помогает строить автоматизацию. Примеры для бизнеса, заявленная стоимость и порядок проверки.
Jev от TypeSafe AI: как встроить быстрые решения в бизнес-процессы
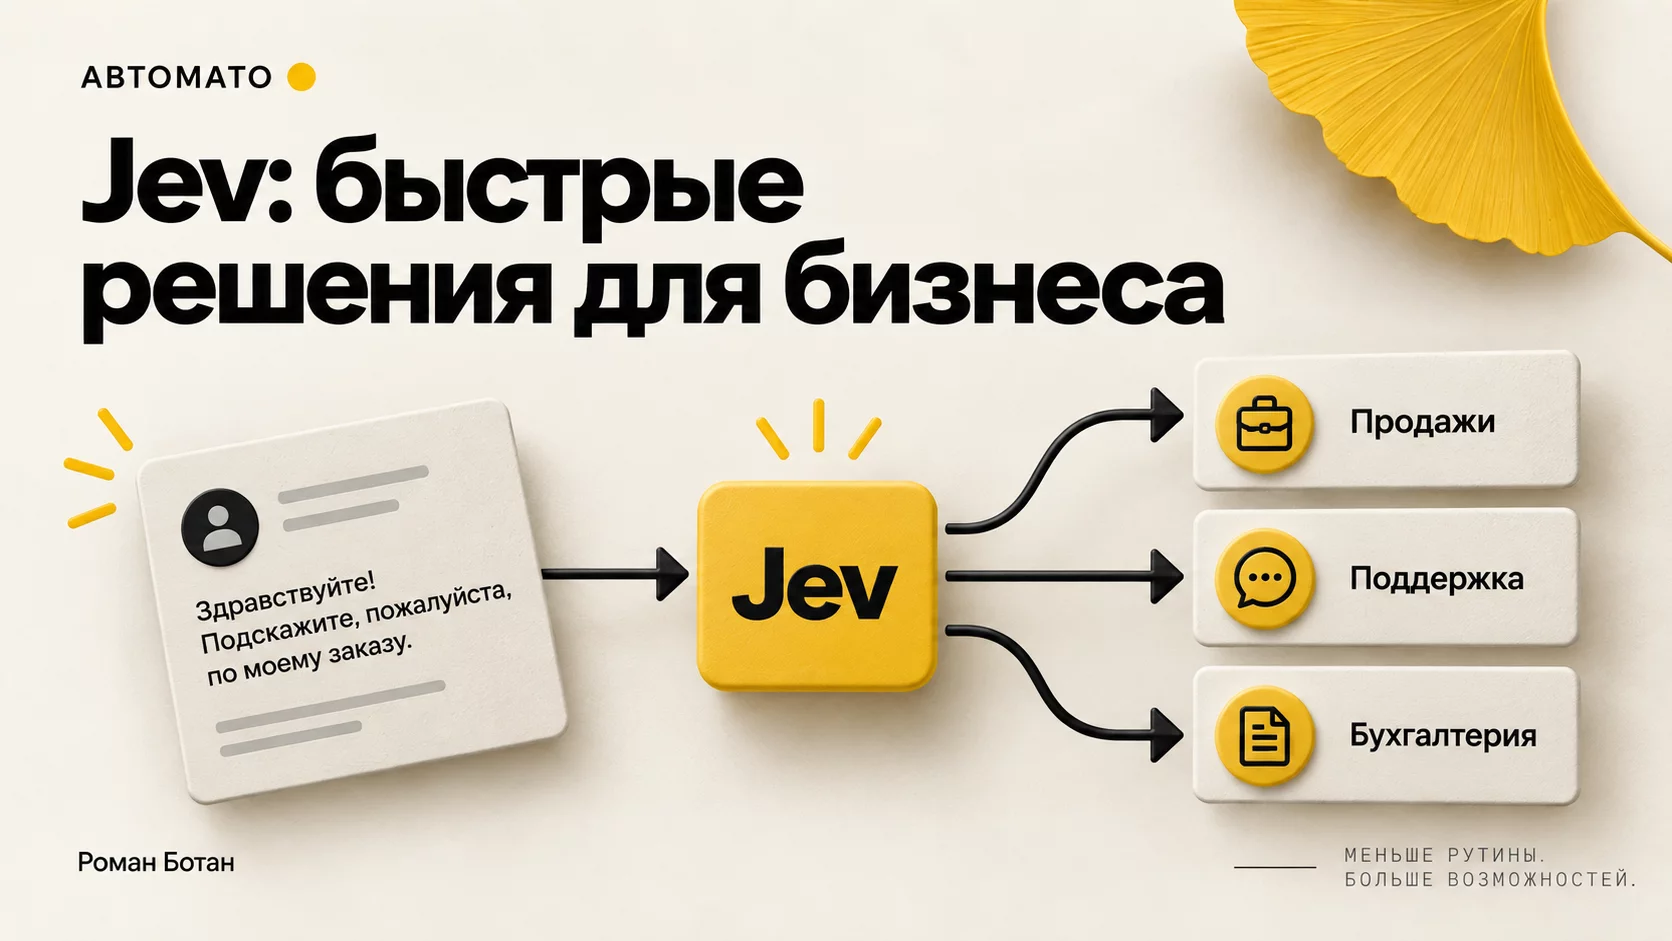
Допустим, у вас на сайте приходят обращения. Один человек хочет купить, второй просит акт, третий пишет, что оплата прошла, а доступ к продукту так и не появился.
Первое действие в каждом случае довольно простое: понять, кому передать сообщение и насколько быстро им надо заняться. Если обращений много, на такой сортировке можно потерять вполне ощутимое количество рабочего времени.
Вот для подобных задач и появился Jev от TypeSafe AI. Это модель, которая читает входные данные и возвращает решение в заранее заданном формате: категорию, оценку по шкале или вероятность ответа «да». Дальше программа использует результат в своей работе. Устроено это как небольшой интеллектуальный диспетчер внутри процесса. Описание Jev.
Давайте разберём, где такой подход может пригодиться бизнесу, откуда берутся обещания высокой скорости и что я бы проверил перед внедрением.
Что означает «быстрое мышление»
TypeSafe называет этот класс моделей System One. Название отсылает к описанному Даниэлем Канеманом быстрому, интуитивному мышлению. Jev получил имя в честь Уильяма Стэнли Джевонса: команда рассчитывает, что удешевление вычислений расширит применение ИИ.
Основатель TypeSafe Диого Алмейда участвовал в исследованиях OpenAI, которые легли в основу ChatGPT. Jev компания представила 15 сентября 2026 года в раннем доступе.
Разработчик заявляет новую архитектуру, параллельную обработку ответов и метод обучения RLCD — Reinforcement Learning for Calibrated Decisions. Его задача — научить модель давать оценки, которые адекватно отражают неопределённость. Это описание подхода самой компании. Анонс TypeSafe.
Для руководителя здесь полезна сама идея разделения работы. Входящее сообщение можно сначала классифицировать, затем передать нужному сотруднику или следующему инструменту. Генерацию ответа клиенту подключать на том этапе, где она действительно нужна.
Какие решения можно получить
У Jev три основных типа вопросов. Покажу их на примере обращений.
Noul — вероятность ответа «да». Например: «Клиент просит связать его с человеком?» Модель возвращает число от 0 до 1. Значение около 1 означает высокую вероятность положительного ответа, около 0 — отрицательного. Значение около 0,5 показывает неопределённость. Название в документации пишется именно Noul. Как устроен Noul.
Choice — выбор из заданных вариантов. Можно задать отделы: продажи, поддержка, бухгалтерия. В ответе будут выбранная категория, вероятности вариантов и показатель уверенности confidence. Перечень допустимых отделов вы определяете заранее. Типы вопросов.
Score — оценка по описанной шкале. Допустим, хотим оценить срочность. Заранее описываем уровни: обычный вопрос, затруднение в работе, полная остановка доступа. Модель возвращает оценку и распределение вероятностей по уровням. Чем понятнее описаны границы, тем проще проверять результат. Как устроен Score.
Это позволяет разложить одно обращение на несколько вопросов: что произошло, кто должен разбираться, насколько срочно. Правила дальнейших действий остаются в программе.
Как это могло бы работать в компании
Возьмём условное сообщение: «Оплатил обучение, деньги списались, в кабинет зайти не могу. Начало через час».
Мы передаём текст и отдельно спрашиваем про тему обращения, проблему с доступом и срочность. Затем связываем ответы с рабочим процессом:
- Обращение попадает в очередь поддержки.
- Проблема с доступом и близкое начало занятия повышают приоритет.
- Сотрудник получает исходное сообщение и результаты классификации.
- При неоднозначном результате обращение уходит на ручной разбор.
Это пример возможной интеграции. Подключение к вашей CRM, постановку задач и уведомления надо настроить отдельно.
Я бы начинал именно с такой задачи: понятный вход, небольшой список вариантов и возможность быстро проверить, куда ушло обращение. На истории переписки сразу будет видно, где модель помогает, а где путается.
Что со скоростью и стоимостью
В анонсе TypeSafe указаны задержка 70–500 мс и цена $0,042 за миллион входных токенов. За выходные токены на момент подготовки статьи отдельная плата не заявлена. Это данные разработчика; собственный замер Jev для этой статьи не проводился. Условия и результаты TypeSafe.
Посчитаем условный пример. Если миллион обращений вместе с инструкциями займёт в среднем по тысяче входных токенов каждое, получится миллиард токенов. По указанному тарифу обработка входа обойдётся в $42.
Но бюджет внедрения будет включать и другие расходы: интеграцию, сервер, хранение, повторные запросы, ручной разбор и работу других моделей. Цена токенов — одна строка в этом расчёте.
Обещание «в сотни раз дешевле» я бы переводил в конкретный вопрос: сколько стоит обработать тысячу ваших обращений с приемлемым качеством? Именно этот показатель имеет смысл сравнивать с текущим процессом.
Уверенность модели: как использовать её в работе
В Choice и Score есть confidence. Он рассчитывается из распределения вероятностей и показывает, насколько однозначно модель определилась с ответом. Читать confidence 0,9 как универсальную гарантию «девять решений из десяти будут правильными» было бы ошибкой. У Noul отдельного confidence нет: ориентиром служит сама вероятность ответа «да». Документация confidence.
На практике можно предусмотреть три маршрута. Понятные обращения распределять автоматически. Спорные — отправлять сотруднику с подсказкой. Если данных недостаточно, запрашивать уточнение.
Порог надо подбирать на своей выборке. Ошибочно назначенный отдел и ошибочно выполненный возврат денег имеют разные последствия. Для действий с деньгами я бы оставил отдельную проверку и подтверждение ответственным человеком.
Ещё один момент: правильная структура ответа и правильность решения проверяются отдельно. Модель может вернуть допустимую категорию и при этом ошибиться с отделом. Поэтому аккуратный формат данных сам по себе ещё ничего не говорит о качестве обработки ваших обращений.
Где ещё я бы рассмотрел Jev
Распределение задач между моделями. Сначала определить тип и сложность запроса, затем направить его подходящему исполнителю. Экономия зависит от того, сколько задач удастся распределять правильно и сколько будет стоить весь маршрут.
Первичная проверка сообщений. Выделять обращения с жалобой, просьбой о возврате или признаками спама. Для спорных случаев предусмотреть очередь проверки и возможность исправить решение.
Сортировка заявок менеджеру. Оценивать по заданным признакам, какие заявки требуют быстрого ответа. Критерии здесь должен определить сам бизнес: срочность, наличие конкретного запроса, готовность исходных данных.
Проверка результата другого ИИ. Например, есть ли в подготовленном ответе обещание срока, которого нет в исходных условиях. Для этого надо передать сами условия и сформулировать узкий проверочный вопрос.
Во всех этих сценариях я бы отдельно считал пропущенные важные случаи. Общий процент правильных ответов может выглядеть хорошо, пока несколько срочных обращений регулярно оказываются в конце очереди.
С чего начать технически
В официальном руководстве есть Playground и прямой API TypeSafe. После получения доступа можно передать текст в поле state и описать вопросы в questions. Ниже — пример тела запроса по документированной схеме; в этой статье он приведён для объяснения и через API не запускался. Quick Start.
{
  "model": "jev-latest",
  "state": "Оплатил обучение, но доступ в кабинет не появился.",
  "questions": {
    "access_problem": {
      "type": "noul",
      "instructions": "Сообщает ли клиент о проблеме с доступом к обучению?"
    },
    "department": {
      "type": "choice",
      "instructions": "Какой отдел должен первым разобрать обращение?",
      "criteria": {
        "sales": "Выбор и покупка обучения",
        "support": "Доступ и технические проблемы",
        "accounting": "Закрывающие документы и реквизиты"
      }
    }
  }
}
Разработчик затем добавляет обработку ответа, правила маршрутизации, журнал решений и поведение при недоступности сервиса. Полезно заранее определить, кто получает обращение, если запрос завершился ошибкой или модель вернула спорную оценку.
Как я бы проверял пользу
Собрал бы несколько сотен обезличенных обращений: обычные, неоднозначные и редкие важные случаи. Часть использовал бы для настройки вопросов, часть оставил бы для итоговой проверки.
Дальше сравнил бы результат с разметкой сотрудников: куда должно уйти сообщение, что требует срочной реакции, где нужна дополнительная информация. Отдельно посмотрел бы стоимость, задержки и долю обращений, которые всё равно приходится разбирать вручную.
Первый запуск можно провести параллельно с обычной работой: система предлагает маршрут, сотрудник продолжает принимать решение. Так появляется материал для настройки порогов и понятная оценка пользы.
У Jev интересная специализация: множество небольших решений внутри повторяемого процесса. Если у вас есть такая работа, начните с одной операции. Опишите входные данные, допустимые ответы и способ проверки. На этом примере и станет понятно, имеет ли смысл двигаться дальше.
Материал подготовлен по официальным источникам, проверенным 22 сентября 2026 года. Условия доступа и тарифы могут меняться. Примеры внедрения в статье — предлагаемые сценарии; собственный тест модели не проводился.